文:李浩裁剪:经纬
智驾不错约束 OTA,但汽车里的芯片,在出厂时就还是定了下来。
这是智能汽车行业共同面对的难题。一辆车要使用多年,支抓智能体验的时间却在快速更新。新芯片天然大要运转更复杂的标准,但关于还是售出的车辆来说,芯片规格执意成为定数。
淌若新智商恒久与新硬件绑定,新老车型之间的体验差距就可能约束拉大。
旧车也就濒临着时间落伍带来的价值折损。抗击“时间贬值”,意味着车企在车卖出去、钱收进来之后,还要持续为老用户过问研发。新智商能不成回到老车上,决定着“抓续升级”的答应有若干重量,也影响着用户对品牌的信任。
9 月 10日,理思汽车开启 OTA 8.6、OTA 9.1.1 版块推送。其中,OTA 8.6 将理思马赫 VLA 2.0 带到搭载 Orin-X、Thor-U 平台的已寄托 AD Max 车型,笼罩多款 2022 至 2025 款干系车型,触及近百万用户。
这终澄莹理思在 6 月 15日 Livis Day 上作出的三季度升级答应。李思在微博中提到,团队为此履历了几个月的模子蒸馏、平台适配和多轮考证。
车主看到的是下载与装配,研发团队面对的,却是如何把归拢套锤真金不怕火体系产出的智商,送到三种不同芯片上。抗击 “ 时间贬值 ” ,需要先把这说念工程题解开。
旧芯片有我方的法例
把理思马赫 VLA 2.0 的智商带回老车型,要管束的问题远比芯片参数各异更复杂。
在这次的更新中,OTA 8.6 面向 2022 至 2025 搭载AD Max的干系车型,OTA 9.1.1 面向 2026 年发布的新车型。
模子运转时,要完成矩阵乘法、归一化等一系列运算,通常称为“算子”。谁来狡计、先算哪一步、中间松手放在何处,都会影响速率。
这也就意味着,沟通的数学任务在不同的平台上运转,底层的施行有遐想就可能重新遐想。
而这次通过 OTA 8.6 得到新模子的已寄托 AD Max 车型,搭载的是英伟达 Orin-X 和 Thor-U。两者的 GPU 分辨采用 Ampere 和 Blackwell 架构。即便同出一家厂商,两代平台也有不同的狡计要求。
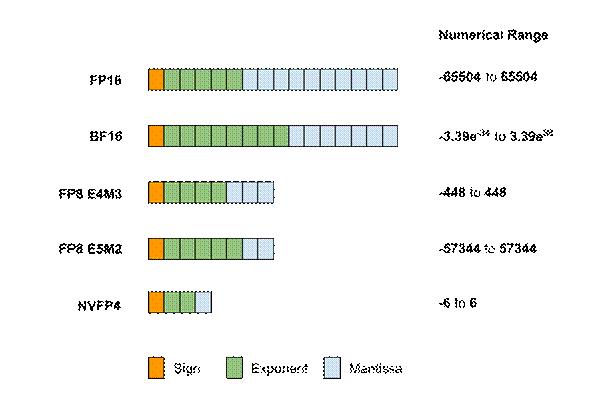
各异领先体咫尺低精度狡计上。Thor-U 支抓 FP4、FP8,Orin-X 的高效部署主要依赖 INT8。这意味着两代芯片有着不同的数值暗示体式,影响模子中的权重和中间特征如何存储,以及狡计单位如何处理这些数据。
(英伟达官方浮点体式位结构图,图源:NVIDIADeveloper,《Model Quantization: Concepts, Methods, and Why It Matters》)
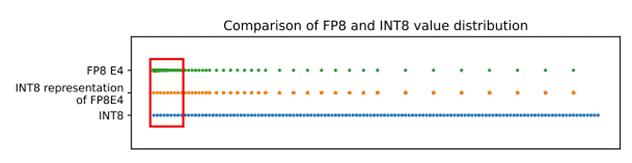
比如 FP8 和 INT8 一样各占用 8 位,但 INT8 属于均匀量化,相邻刻度之间的断绝固定;FP8 则是浮点体式,通过指数和余数暗示数值,所能暗示的数值间距会随量级大小而变化。因此,围绕 FP8 遐想的量化有遐想,转向 INT8 时,需要重新处理数值范围与过失分拨的问题。
FP8 与 INT8 数值散播对比图,图源:Qualcomm AI Research,《FP8 versus INT8 for efficient deep learning inference》)
这就需要用有代表性的数据进行量化校准,估量权重和中间特征的数值散播,收受缩放总计偏执作用范围。与此同期,时间团队还要评估哪些层合适缩小精度,哪些敏锐运算需要保留较高精度。部署能省下若干狡计和存储,必须与模子输出受到多大影响全部讨论。
数值体式以外,还要探求算子若何落到硬件上。
矩阵乘法、卷积等运算,都需要由具体的狡计内核施行。遐想芯片是否支抓相应的低精度指示,推理框架有莫得匹配的实现,数据维度和排布能否进入高效狡计旅途,都会影响实质速率。迥殊的体式更始,也可能对消一部重量化收益。因此,换一个平台,狡计内核的收受、数据布局和任务分块方法,都需要重新评估。
此外,模子权重与中间特征能否装入内存、数据能否实时投递狡计单位,也会影响部署有遐想的收受。
关联词理思的工程师们濒临的不啻这些。
理思自研的马赫 M100,使用的是透顶不同的狡计与数据流动的组织方法。
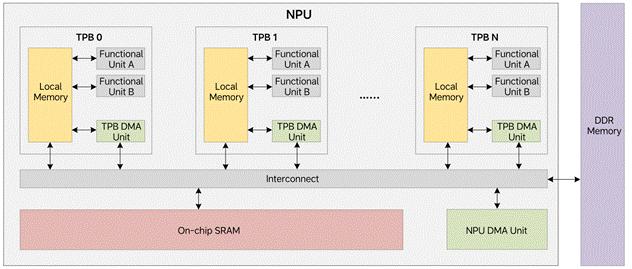
(马赫 M100 NPU 的存储系统与数据搬运结构,图源:理思《M100: An Orchestrated Dataflow Architecture Powering General AI Computing》)
理思团队的论文流露,M100 的神经蚁集处理单位(NPU)采用数据流架构,减少对多级缓存的依赖,以腹地存储和片上 SRAM 相连数据,通过 DMA 显式搬运,并由编译器和运转时组织同步。
基于这套遐想,编译器凭据模子的数据依赖,将张量分块、把算子映射到狡计单位,并安排各要领活水施行。这么不错让数据传输与狡计尽量叠加,减少狡计单位恭候数据的时候,擢升硬件支配率。
英伟达 GPU 的典型 CUDA 施行,则以线程和线程块组织任务,借助寄存器、分享内存体恤存支抓运算。GPU 一样大要叠加狡计与数据传输,但任务如何切分、数据放在何处、不同施行单位如何同步,需要匹配自己的硬件资源与编程敛迹。
因此,在 M100 上高效运转的施行安排,迁徙到 Orin-X 或 Thor-U 时,就需要重新寻找适总遐想平台的实现方法。
这些休养还会相互牵动。淌若为了傲气时延和功耗要求,进一步蜕变模子结构或输入 Token 的数目,狡计量、中间特征范围和数值散播也会变化。此前信托的量化与内存有遐想,需要随之复查;输入信息经过更多压缩后,模子能否保留奢靡的说念路连气儿智商,也要重新考证。
理思露馅的针对 Orin-X、Thor-U 分辨遐想模子结构、Token 预算、蒸馏有遐想、量化战术与部署优化,对应的恰是这些相互关联的工程收受。
归拢套锤真金不怕火体系不错办事多个平台,但车端的模子树立与施行有遐想,需要针对具体芯片分辨优化。跨平台寄托的难度,就在于把归拢套智商,落实为各个平台都能强壮、高效运转的模子。
参数瘦下去,智商如何留住来
模子装得下,仅仅过了硬件这一关。
按照理思露馅的门道,团队先在云表锤真金不怕火范围更大、智商更强的老师模子,再针对车端芯片遐想学生模子。学生模子需要在既定的算力、内存和功耗预算内完成推理,因此,输入若干信息、用多大的蚁集处理,都需要围绕遐想芯片重新遐想。
马赫 M100、Thor-U、Orin-X 承担部署与推理,分享锤真金不怕火体系,但各自受到不同的狡计资源敛迹。
针对 Orin-X 和 Thor-U,理思从输入与采集结构两头阻抑狡计职守。Token压缩减少连气儿画面中的冗余信息,缩减后续蚁集需要处理的特征范围;结构压缩则蚁合神经蚁集架构搜索,休养蚁集层数、通说念等树立,在智商与资源耗尽之间寻找均衡。
经过这两步,小模子得到了进入老芯片的要求,但原有智商能保留若干,还需要重新锤真金不怕火来汇报。
蒸馏承担的,恰是这部单干作。
在经典的输出蒸馏中,老师给出的概率散播会当作“软遐想”。学生对归拢输入作出瞻望,通过交叉熵等耗损函数讨论与老师输出的差距,再支配反向传播更新自己参数。监督信号由此包含了最终松手以外的信息,举例其他候选松手之间的相对关系。
放到驾驶任务里,只保留一个最终动作,提供的教唆昭着还不够。
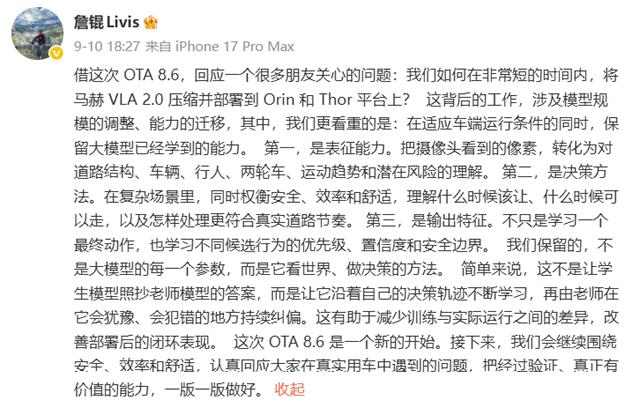
(图源:詹锟微博)
理思汽车基座模子致密东说念主詹锟在微博中强调,需要保留的包括表征智商、决策方法和输出特征。模子既要连气儿说念路结构、交通参与者和畅通趋势,也要保留对候选活动优先级、置信度与安全鸿沟的判断,智力在安全、成果和赋闲之间作出收受。
这意味着,压缩后的模子需要学会在不同说念路要求下保管合理的判断关系。沟通场景下都收受绕行,并不成单独阐明两个模子领有接近的智商;要求发生变化后,收受能否随之休养,一样坚苦。
而连气儿驾驶,又让这说念题多了一层难度。
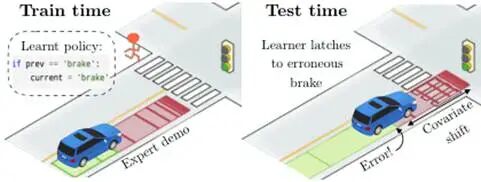
(失实动作通过反馈,形成后续决策抓续偏离,图源:Feedback in Imitation Learning: The Three Regimes of Covariate Shift)
在效法学习中,淌若锤真金不怕火主要依赖老师走过的轨迹,学生看到的便是老师战术产生的情状。但部署之后,学生会按照我方的战术活动。一次制动时机或横向位置的偏差,就可能蜕变下一步的不雅察要求,使后续决策渐渐偏离锤真金不怕火时老到的情状。这类由自己活动引起的散播偏移,会让过失在连气儿决策中积蓄。
单帧瞻望接近老师,无法径直推导出连气儿驾驶也接近老师。这意味着,需要抓续的监督和矫正。
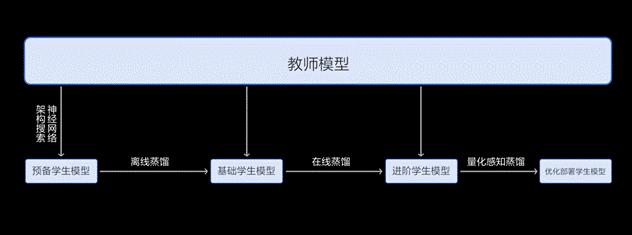
(理思 OPD 模子蒸馏经由,图源:理思官方抖音账号)
理思采用的 OPD,即 On-Policy Distillation,将学生自己的决策轨迹纳入锤真金不怕火。按照这一方法的通用机制,学生先依据现时战术生成轨迹,老师在相应高下文中提供监督,再据此更新学生参数。跟着学生战术变化,锤真金不怕火持续从更新后的战术采样,使教唆大要跟上学生自己产生的偏差。
OPD补上的,恰是模子压缩后最容易遗漏的一环——不仅要让学生学会老师“如何作念”,还要让它在我方走偏之后,知说念“接下来如何办”。
升级的科场在泛泛说念路上
模子适配之后,职责并莫得松手。
据理思先容,往时几年,公司渐渐缔造了自研模子、Harness 体系、自研星环 OS、编译器团队和自研芯片五项智商。这次 Orin-X、Thor-U 双平台升级,赶巧把这些过问拉到了归拢说念题里。
模子团队需要处理锤真金不怕火、蒸馏与智商迁徙,编译器致密让模子安妥不同芯片的算子与施行方法,星环 OS 则参与狡计任务与整车系统之间的协同。Harness 体系,则进一步参与模子智商向量产功能的工程化敛迹与寄托。
按照理思露馅的经由,接下来还要经过算法评测、仿真评测、初步实车测试和多城市泛化测试,并把用户反馈持续纳入后续迭代。
因为到了实车,着实传感器输入、端到端狡计时延和车辆施行反应都会加入进来;再把车开到不同城市,说念路结构、交通参与者和驾驶民风发生变化,锤真金不怕火的则是模子的泛化智商。
终末,这些复杂职责会被压缩成几个车主很容易感知的变化。
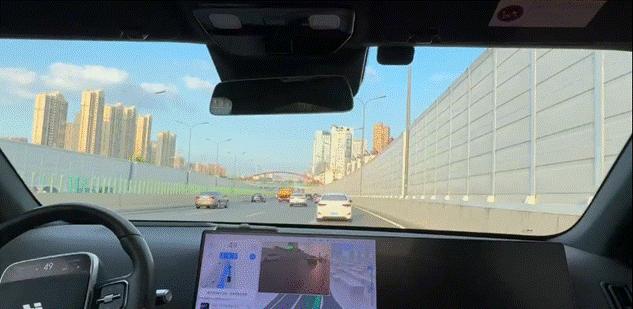
(在左后方加塞的情况下博弈愈加丝滑,图源:蚁集)
理思马赫VLA 2.0 重心改善了绕行、变说念、跟车与说念路博弈。碰到施工占说念和临泊车辆,车辆会更早判断可通行空间;变说念时,需要同期探求侧后方车辆的距离、速率与趋势;前车起步和提速后,跟车反应愈加实时;面对汇流、穿插,则减少莫得必要的反复加延缓。
这些每天都会重复出现,但也正因为重复,车主不需要知说念什么是 Token、蒸馏或者 OPD 就能感受到升级之后的变化。
实验室致密评释模子不错迁徙,泛泛说念路才致密汇报智商有莫得信得过迁往时。
这次 OTA 也不惟有 VLA驾驶。
(理思AI眼镜 Livis造就泊车,图源:理思)
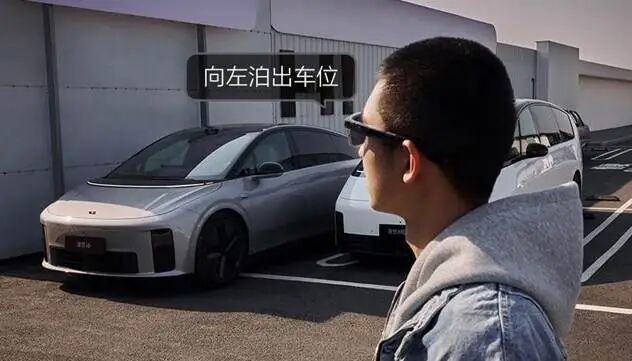
OTA 8.6 持续把更新蔓延到泊车、补能和座舱。造就泊车不错通过理思同学 App、理思 AI 眼镜 Livis 镜在车外发起操作,备车电板预冷和多时段预约充电则进一措施整补能体验;艺术相框让图片、视频进入座舱。同期 OTA 9.1.1 还把主动悬架接入游戏,在车辆静止时调用还是装在车上的底盘硬件。
诚然这些细节的坚苦进程天然不成和理思马赫 VLA 等量王人不雅,却阐明了归拢件事——汽车寄托之后,还是装上车的芯片、传感器和施行机构,仍然不错被新的软件重新调用。
这也让“抓续进化”有了另一层含义。
把最新时间装进新车,是家具迭代;兴隆花几个月,把它重新塞进几年前卖出的车里,则是另一趟事。前者决定下一辆车好不好卖,后者决定还是付过钱的东说念主,会不会被留在上一代。
从智商作念出来,到跨平台适配,再到近百万老车型信得过用上,也不外短短几个月。
把畴昔卖给新用户不难开云(中国)kaiyun网页版登录入口,难的是时间持续往前时,还兴隆回头带上老用户全部走。
上一篇:开云体育这个波动可能达到50mmHg以上-开云「中国」kaiyun体育网址-登录入口
下一篇:没有了